


Gast: Jan Czichos
Periodische Überprüfung & selektives „Aussperren“ schützt Inhalte und erhöht Performance
InVEST
Return
Intro
[0:00] Ein ganz herzliches Willkommen zu einer neuen Folge des Unternehmer-Podcast. Hier ist der Jan von Webgefährte.
Warum Bots Beachtung finden sollten
[0:11] In der heutigen Solo-Folge habe ich ein ganz besonderes Thema mitgebracht. Wir wollen heute über Bots sprechen, also sogenannte nichtmenschliche Besucher unserer Webseite. Das macht aus verschiedenen Gründen Sinn, dass wir über diese Form der Nutzer unserer Webseite auch mal im Detail nachdenken. Denn es gibt nicht nur gutartige sozusagen Bots, sondern es gibt auch die, die unserer Webseite oder gegebenenfalls sogar unseren Inhalten auf der Webseite, die wir mit Mühe erstellt haben, auch schaden können. Aus diesem Grund möchte ich heute einmal in dieses Thema gemeinsam mit euch etwas tiefer einsteigen. Grundsätzlich ist es wichtig zu wissen, dass Bots ein integraler Bestandteil des Internets sind. Sie beschaffen Informationen, um sie tatsächlich auch strukturiert, beispielsweise für Suchmaschinen, zur Verfügung zu stellen. Und das ist gerade für uns, die sich mit SEO beschäftigen oder auch digitalem Marketing im Social-Media-Umfeld betreiben, ganz essentiell und wichtig. Und aus diesem Grund gilt es, die sogenannten…
[1:30] Schwarzen von den sogenannten weißen Schafen auch sinnvoll voneinander zu unterscheiden und für die schwarzen Schafe auch geeignete Maßnahmen im Petto zu haben, um die Sicherheit und Vertrauenswürdigkeit unserer Seite sicherzustellen.
Arten von Bots
[1:47] Schauen wir uns einfach mal an, welche Arten von Bots es im Internet gibt. Über die sogenannten nützlichen Bots hatte ich schon kurz gesprochen. Das wären beispielsweise der Google- oder der Bing-Bot, die auf unsere Webseite kommen, um neue Inhalte zu identifizieren und sie zurück in die Suchmaschine zu speisen. Von dort aus sie dann auch den interessierten Suchern zugänglich werden.
[2:15] Auch ein nützlicher Bot ist beispielsweise der MJ12-Bot. Das ist eine Community. Den Link dazu habe ich in den Shownotes unten vermerkt. Dort wird ein öffentliches Webarchiv zur Verfügung gestellt. Jeder ist wahrscheinlich schon mal in die Verlegenheit gekommen, dass er etwas sucht im Internet, von dem er in der Vergangenheit gehört hat, dessen Webseite aber es öffentlich nicht mehr gibt. Und in solchen Fällen kommen Webarchive sehr nützlich zum Einsatz. Denn dort sind alte Webseiten, die über einen geraumen Zeitraum schon nicht mehr betrieben werden, noch immer verfügbar und können dort noch angeschaut bzw.
[3:02] Besucht werden. Kommen wir zur zweiten Art, den sogenannten unerwünschten Bots. Da gibt es zum einen die klassischen Scraper-Bots, also das sind die, die die Webseite durchforsten und Inhalte für eigene Zwecke kopieren, worüber wir dann später keine Kontrolle mehr haben. Es gibt die sogenannten Traffic Bots, die fallen auch in die Kategorie der unerwünschten Bots und sind die, die sogenannten künstlichen Traffic auf der Seite verursachen und damit auch die Statistiken, unsere Besucherstatistik beispielsweise, verzerren. Und dann meine persönlichen Lieblinge, die Spambots. Das sind die, die unsere Webseite besuchen und beispielsweise in Kommentaren oder in Formularfeldern entsprechende, wie soll ich sagen, mehr oder weniger hilfreiche Informationen eingeben und entsprechend abschicken. Damit haben wir eine Übersicht. Zwei Kategorien und wie man sich sicher jetzt schon vorstellen kann, gibt es für jede dieser Kategorien auch geeignete Maßnahmen. Doch dazu gleich mehr.
Identifikation von Bots
[4:22] Zunächst schauen wir uns noch ganz kurz an, wie können wir beispielsweise identifizieren, dass es sich hierbei um einen Bot bzw. Um was für einen Bot es sich handelt. Zum einen gibt es die Möglichkeit, über Analyse-Tools, wie wir zum Beispiel auch im Gruppensystem verwenden.
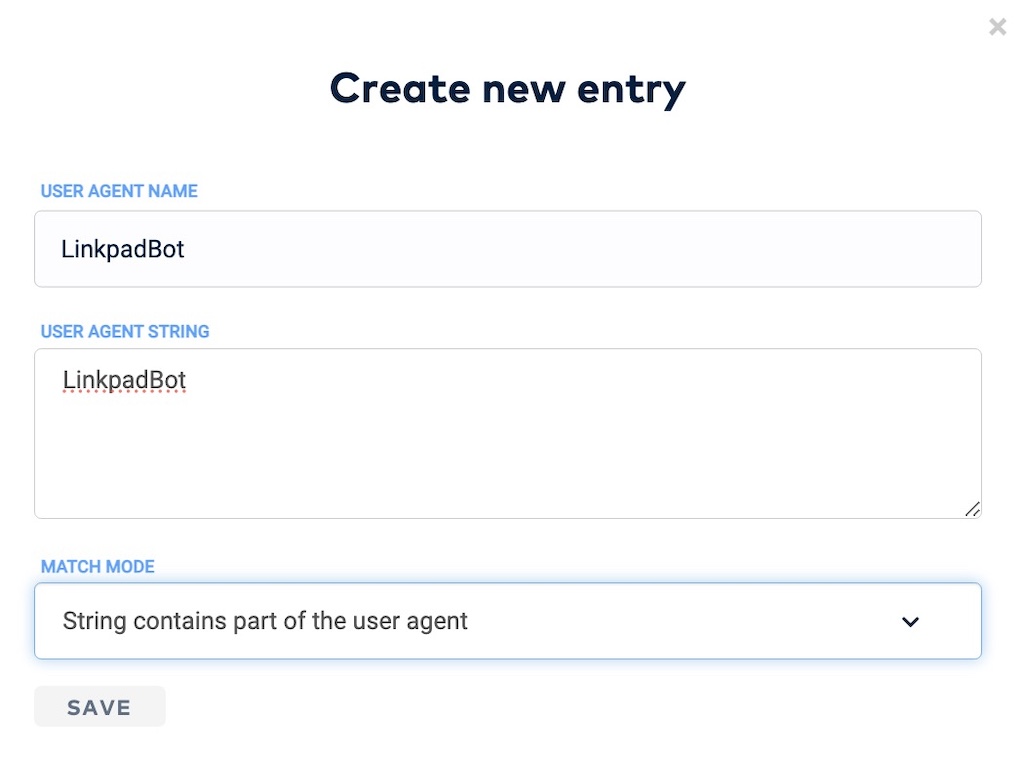
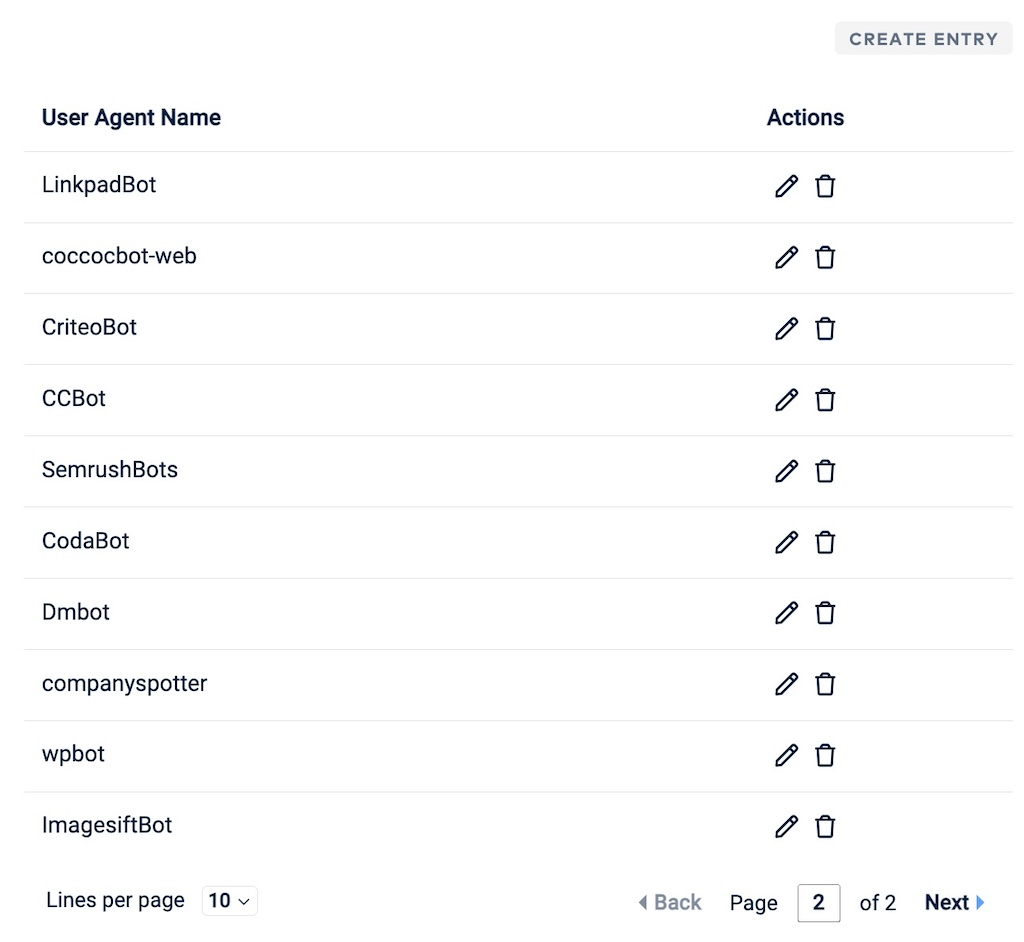
[4:43] Matomo, dort die Möglichkeit, die sogenannten Besucher-Logs auszuwerten und dort nach sogenannten User-Agents zu suchen. Das erkläre ich gern unten nochmal in den Shownotes für diejenigen, die das nochmal im Detail nachlesen können. Und über diese sogenannte Bezeichnung eines Besuchers, in dem Fall für menschliche als auch für nichtmenschliche Besucher, dort verfügbar ist, lassen sich Bots identifizieren und damit auch tiefer analysieren, doch dazu gleich mehr. Die zweite Möglichkeit, einen Bot zu identifizieren und zu erkennen, ist einfach, auf dem Server das sogenannte Access Log anzuschauen. Das ist eine Protokollierung, die in unserem Gruppensystem beispielsweise auch der Web-Hoster einfach zur Verfügung stellt und die man in regelmäßigen Abständen entsprechend analysieren kann. Und bei uns ist es sogar so, dass wir auf Anfrage dort eine gefilterte Liste bekommen, in der nur die sogenannten nicht-menschlichen Besucher aufgelistet sind und die von unserer Seite dann weiterverarbeitet werden kann.
4 Kriterien zur Bewertung
[5:59] Schauen wir uns nun an, nach welchen Kriterien wir beispielsweise Bots in diese beiden Kategorien, also gewünscht oder unerwünscht, entsprechend einteilen können.
[6:13] Das ist zum einen die Fragestellung, verursacht der Bot auf unserer Webseite unnötig viel Traffic? Also wenn wir uns beispielsweise dort anschauen, wie lange ein Bot auf der Seite bleibt, beziehungsweise wie viele Unterseiten er besucht hat. Diese Information ist aus dem sogenannten Access Log bereits verfügbar. Auch hierzu am Beispiel unten in den Shownotes, wo man dann ablesen kann, Im Vergleich zu den menschlichen Nutzern, wie viel Serverkapazität wird von dem jeweiligen Bot beansprucht. Und wenn wir das im zeitlichen Kontext betrachten, wie häufig er kommt, können wir daraus eine gute Entscheidung ableiten. Der nächste Punkt.
[7:03] Beeinflusst der Bot beispielsweise unsere Nutzerstatistiken, also die Analytics-Daten? Hier haben wir beispielsweise im Sharing-System eine einfache Möglichkeit, die menschlichen von den nichtmenschlichen Besuchern zu unterscheiden und Bots von vornherein aus der Analyse-Statistik entsprechend zu entfernen. Auch hierzu ein Beispiel unten in den Shownotes. Das dritte Kriterium ist die Frage, ob der Bot von einer seriösen Quelle kommt. Hier schauen wir uns an, ob der Bot auch im Internet entsprechend dokumentiert ist.
[7:44] News-Beitrag, hierzu ein Beispiel, auch mit ein paar Leitlinien, wie man entscheiden kann, ob dieserjenige Bot von einem sogenannten Operator oder von einer vertrauenswürdigen Quelle kommt, der wir auch unsere Daten anvertrauen wollen. Auch hierzu den Link in den Shownotes. Und die vierte Frage, welche Auswirkungen hat der Bot auf die Leistung unserer Webseite? Das heißt, nicht nur wie lange oder wie häufig kommt derjenige, sondern wie intensiv sind denn dort die Besuche. Werden beispielsweise Kontaktformulare unnötig von einem solchen Bot beansprucht, weil dort Daten eingegeben werden? Oder versucht sich beispielsweise ein Bot sogar an dem Anmeldeformular für unseren Mitgliederbereich zu schaffen zu machen, was natürlich auch die Leistung der Webseite beeinflusst und sozusagen bis soweit gehen kann, dass die Webseite auch Schaden nehmen kann.
[8:43] Indem die Webseite nicht mehr verfügbar ist oder sogar, dass die Webseite gehackt wird. Also das sind vier Kriterien, mit denen wir gut entscheiden können, ob wir einen Bot entsprechend blockieren oder nicht.
Optionen zum Blockieren
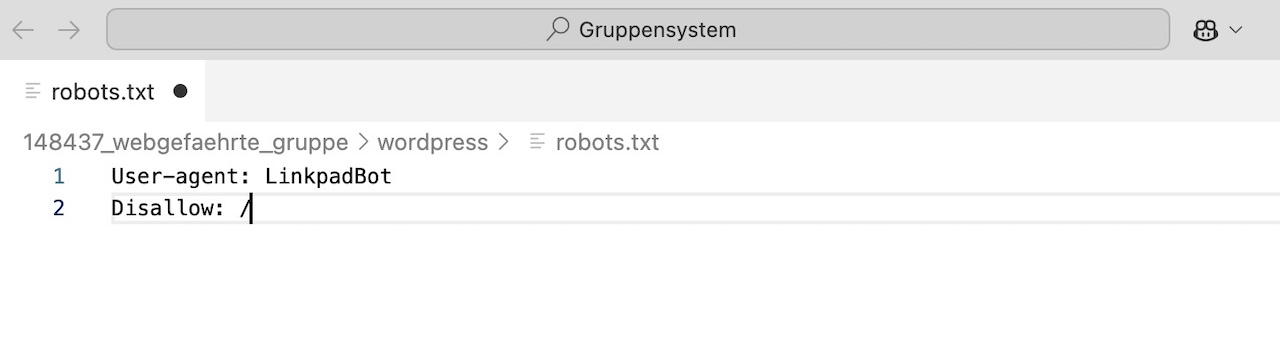
[8:58] Apropos blockieren, wie erfolgt das Ganze? Auch hierzu noch zwei Möglichkeiten. Das eine ist eine sogenannte schwarze Liste, die heißt im WordPress-Kontext Robots.txt. Auch hierzu ein Beispiel in den Show Notes, wie es aussieht, wenn ein Bot entsprechend blockiert wird. Die zweite Möglichkeit, einen unerwünschten Bot auszusperren, ist die Verwendung einer von Firewall-Regeln beispielsweise für den Web-Server oder ein Sicherheits-Plugin im WordPress, um den schädlichen Bot entsprechend dort die Tür zu versperren. Das wäre mal grundsätzlich alles aus meiner Sicht Wissenswerte für uns Einzelunternehmer zum Thema Bots.
Resümee
[9:47] Bots sind ein unvermeidlicher Bestandteil des Internets. Es gibt auf der einen Seite nützliche und weniger nützliche Bots und wir müssen genau diese schwarzen von diesen weißen Schafen unterscheiden, indem wir die Zugriffsstatistiken beispielsweise auf unserer Webseite regelmäßig anschauen. Bei uns im System machen wir das einmal im Quartal und analysieren tatsächlich die Bots, die wir noch nicht auf der Webseite vorher gesehen haben und entscheiden dann anhand der vier Kriterien, ob wir den Bots den Zugriff auf die Webseite gewähren wollen. Und ja, wer sich unsicher ist über den einen oder anderen Bot und wie er diesbezüglich eine Entscheidung treffen kann, den lade ich herzlich ein, einfach unten unter der Folge im Kommentarfeld einen Hinweis zu hinterlassen. Dann schauen wir uns gemeinsam die jeweiligen Informationen an und ich gebe auch gerne eine Empfehlung, wie ich persönlich damit umgehen würde.
[10:54] Wem das Solo-Format von heute gefallen hat, der gibt mir bitte einen Daumen hoch. Auf der anderen Seite, wer Feedback oder Anregungen hat zu dem Kurzformat, da freue ich mich auch jederzeit über eine Rückmeldung, am besten per E-Mail an jan.webgefährte.de. In diesem Sinne, bleiben Sie neugierig auf weitere Erfolgsrezepte aus der Webgefährten-Community und mir gewogen bis zur nächsten Folge. Bis dahin wünsche ich eine gute Zeit und allzeit gute Rankings.
Ihr Jan von Webgefährte.
Show notes
Begriffsklärung:
- Crawler sind ein spezieller Typ von Bot, die Webseiten durchstöbert und Informationen darüber sammelt. Diese Daten helfen Suchmaschinen wie Google, Webseiten zu verstehen und zu bewerten. Ein Crawler besucht jede Unterseite einer Website, um die Inhalte vollständig zu erfassen. So kann Google etwa deine Website indizieren und bei relevanten Suchanfragen anzeigen.
- Eine Firewall ist eine Sicherheitsmaßnahme, die den Datenverkehr zu einer Website filtert und schützt. Sie blockiert schädliche Anfragen oder Zugriffe und kann gezielt Bots aussperren, die schädlich oder unerwünscht sind. Für Webseitenbetreiber ist eine Firewall oft ein Schutz vor böswilligen Bots oder Hackerangriffen.
- Plugins sind Erweiterungen, die in Content-Management-Systemen wie WordPress verwendet werden, um zusätzliche Funktionen zur Website hinzuzufügen. Im Online-Marketing gibt es Plugins für SEO, Kontaktformulare, Analysen und Sicherheit. Ein Beispiel: Ein SEO-Plugin kann dir helfen, deine Website für Suchmaschinen zu optimieren, während ein Sicherheits-Plugin den Zugang für schädliche Bots einschränken kann.
- Log-Files sind Protokoll-Dateien, in denen die Aktivitäten auf einer Website dokumentiert werden. Sie speichern Informationen über jeden Besucher, darunter IP-Adressen, Besuchszeit, besuchte Seiten und User-Agents.
- Ein Robot, auch kurz Bot genannt, ist ein Programm, das automatisierte Aufgaben im Internet ausführt. Im Online-Marketing werden Bots häufig eingesetzt, um Daten zu sammeln oder Webseiten zu durchsuchen.
- Die robots.txt-Datei ist eine einfache Textdatei, die Webseitenbesitzer auf ihrem Server ablegen können, um Crawlern mitzuteilen, welche Seiten sie besuchen dürfen und welche nicht. Zum Beispiel kann ein Unternehmer mit einer robots.txt verhindern, dass bestimmte Seiten wie die Admin-Oberfläche von Crawlern erfasst werden, um diese Inhalte zu schützen.
- Scraper sind Bots, die darauf programmiert sind, gezielt Inhalte von anderen Webseiten zu kopieren und für eigene Zwecke zu nutzen. Im Kontext von Online-Marketing kann das problematisch sein, wenn Inhalte ohne Erlaubnis kopiert werden, z. B. Produktinformationen, Blogposts oder andere Daten, die dann auf fremden Seiten auftauchen.
- Spam über Kontaktformulare oder Kommentarfelder ist unerwünschte Werbung, die die Nutzererfahrung negativ beeinflusst und das Image schädigt.
- Ein Spider ist ein weiterer Begriff für einen Crawler und beschreibt das gleiche Prinzip. Der Spider „krabbelt“ durch das Netz und folgt Links, um Inhalte zu sammeln. Dieser Begriff wird vor allem verwendet, um den Vorgang zu beschreiben, wie Suchmaschinen Informationen von Webseite zu Webseite erfassen, ähnlich wie ein Spinnennetz.
- Ein User-Agent ist eine Information, die vom Browser oder Bot gesendet wird, um sich gegenüber einer Website auszuweisen. Sie zeigt, welches Gerät oder welche Software die Website aufruft. So kann ein Server erkennen, ob der Aufruf von einem menschlichen Benutzer, einem Bot wie dem Googlebot, oder einem anderen Gerät kommt.
Show notes
Begriffsklärung:
- Crawler sind ein spezieller Typ von Bot, die Webseiten durchstöbert und Informationen darüber sammelt. Diese Daten helfen Suchmaschinen wie Google, Webseiten zu verstehen und zu bewerten. Ein Crawler besucht jede Unterseite einer Website, um die Inhalte vollständig zu erfassen. So kann Google etwa deine Website indizieren und bei relevanten Suchanfragen anzeigen.
- Eine Firewall ist eine Sicherheitsmaßnahme, die den Datenverkehr zu einer Website filtert und schützt. Sie blockiert schädliche Anfragen oder Zugriffe und kann gezielt Bots aussperren, die schädlich oder unerwünscht sind. Für Webseitenbetreiber ist eine Firewall oft ein Schutz vor böswilligen Bots oder Hackerangriffen.
- Plugins sind Erweiterungen, die in Content-Management-Systemen wie WordPress verwendet werden, um zusätzliche Funktionen zur Website hinzuzufügen. Im Online-Marketing gibt es Plugins für SEO, Kontaktformulare, Analysen und Sicherheit. Ein Beispiel: Ein SEO-Plugin kann dir helfen, deine Website für Suchmaschinen zu optimieren, während ein Sicherheits-Plugin den Zugang für schädliche Bots einschränken kann.
- Log-Files sind Protokoll-Dateien, in denen die Aktivitäten auf einer Website dokumentiert werden. Sie speichern Informationen über jeden Besucher, darunter IP-Adressen, Besuchszeit, besuchte Seiten und User-Agents.
- Ein Robot, auch kurz Bot genannt, ist ein Programm, das automatisierte Aufgaben im Internet ausführt. Im Online-Marketing werden Bots häufig eingesetzt, um Daten zu sammeln oder Webseiten zu durchsuchen.
- Die robots.txt-Datei ist eine einfache Textdatei, die Webseitenbesitzer auf ihrem Server ablegen können, um Crawlern mitzuteilen, welche Seiten sie besuchen dürfen und welche nicht. Zum Beispiel kann ein Unternehmer mit einer robots.txt verhindern, dass bestimmte Seiten wie die Admin-Oberfläche von Crawlern erfasst werden, um diese Inhalte zu schützen.
- Scraper sind Bots, die darauf programmiert sind, gezielt Inhalte von anderen Webseiten zu kopieren und für eigene Zwecke zu nutzen. Im Kontext von Online-Marketing kann das problematisch sein, wenn Inhalte ohne Erlaubnis kopiert werden, z. B. Produktinformationen, Blogposts oder andere Daten, die dann auf fremden Seiten auftauchen.
- Spam über Kontaktformulare oder Kommentarfelder ist unerwünschte Werbung, die die Nutzererfahrung negativ beeinflusst und das Image schädigt.
- Ein Spider ist ein weiterer Begriff für einen Crawler und beschreibt das gleiche Prinzip. Der Spider „krabbelt“ durch das Netz und folgt Links, um Inhalte zu sammeln. Dieser Begriff wird vor allem verwendet, um den Vorgang zu beschreiben, wie Suchmaschinen Informationen von Webseite zu Webseite erfassen, ähnlich wie ein Spinnennetz.
- Ein User-Agent ist eine Information, die vom Browser oder Bot gesendet wird, um sich gegenüber einer Website auszuweisen. Sie zeigt, welches Gerät oder welche Software die Website aufruft. So kann ein Server erkennen, ob der Aufruf von einem menschlichen Benutzer, einem Bot wie dem Googlebot, oder einem anderen Gerät kommt.
Beispiele zum Absichern der Website:
Weitere Tipps und Quellen
- Leitlinien zur Bewertung von Bots
- Liste geprüfter Bots mit Handlungsempfehlung (Freigabe ggf. anfordern)
- Website (EN) mit umfangreicher Datenbank über Bots im Web
- Historische Entwicklung von Bot-Traffic seit 2019 (Statista)

